気に入った記事をブックマーク

- 気に入った記事を保存できます
保存した記事の一覧は、はてなブックマークで確認・編集ができます
- 記事を読んだ感想やメモを書き残せます
- 非公開でブックマークすることもできます
 www.robotech-note.com
エントリーの編集

エントリーの編集は全ユーザーに共通の機能です。
必ずガイドラインを一読の上ご利用ください。
 0

記事へのコメント0件
- 注目コメント
- 新着コメント
新着コメントはまだありません。
このエントリーにコメントしてみましょう。
このエントリーにコメントしてみましょう。
注目コメント算出アルゴリズムの一部にLINEヤフー株式会社の「建設的コメント順位付けモデルAPI」を使用しています
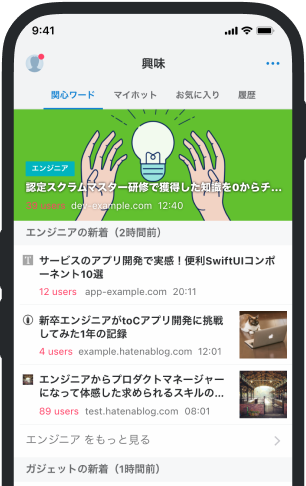
いまの話題をアプリでチェック!
- バナー広告なし
- ミュート機能あり
- ダークモード搭載
関連記事
ローカルLLM マルチGPUの生成速度への影響を評価する - 技術メモ集
概要 以下の記事にて、GPU2枚で40GBのVRAMを搭載したPCを構築しましたが、GPU1枚から2枚に分散すること... 概要 以下の記事にて、GPU2枚で40GBのVRAMを搭載したPCを構築しましたが、GPU1枚から2枚に分散することによってどれほど速度が落ちるのかを評価してみました。結論としては許容範囲内の速度低下だったので一安心。詳細は下をご確認ください。 モデル一つでの評価なので厳密性を求めると微妙ですが、ある程度の傾向はつかめるかなーと。調べたら、もっと詳しい人がより厳密に評価しているとは思いますが、性能の異なるGPUでやった時にどうなるか、あまり情報がなかったんですよね。 www.robotech-note.com 実験の前提 モデルサイズの大小による性能比較 前提の構成として、私のPCはGPU0がRTX3090(VRAM24GB)-16レーンのPCIeに接続、GPU1がRTX4070tis-4レーンのPCIeに接続で、それぞれFP32の演算性能は35.58 TFLOPSと40.09 TFLOP
 www.robotech-note.com
 www.robotech-note.com
 www.robotech-note.com
 www.robotech-note.com
 news.tv-asahi.co.jp
 news.tv-asahi.co.jp
 michsuzuki.hatenablog.com
 web.archive.org
 www.techno-edge.net
 voluntas.ghost.io
 www.docswell.com
 togetter.com
 kdy1.dev
 gigazine.net
 qiita.com
 www.asahi.com
 posfie.com
 www.asahi.com
 suumo.jp
 levtech.jp
 levtech.jp
 levtech.jp