気に入った記事をブックマーク

- 気に入った記事を保存できます
保存した記事の一覧は、はてなブックマークで確認・編集ができます
- 記事を読んだ感想やメモを書き残せます
- 非公開でブックマークすることもできます

 japan.cnet.com
エントリーの編集

エントリーの編集は全ユーザーに共通の機能です。
必ずガイドラインを一読の上ご利用ください。
 0

記事へのコメント0件
- 注目コメント
- 新着コメント
新着コメントはまだありません。
このエントリーにコメントしてみましょう。
このエントリーにコメントしてみましょう。
注目コメント算出アルゴリズムの一部にLINEヤフー株式会社の「建設的コメント順位付けモデルAPI」を使用しています
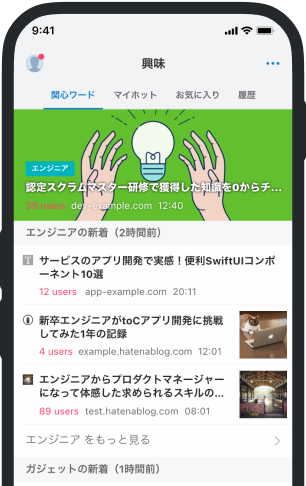
いまの話題をアプリでチェック!
- バナー広告なし
- ミュート機能あり
- ダークモード搭載
関連記事
IBMの復活--DAY3 リサーチ:研究と市場の架け橋
大量のデータのなかから未知のパターンを見つけ出す「データマイニング」は、ある昼食時の会話から生ま... 大量のデータのなかから未知のパターンを見つけ出す「データマイニング」は、ある昼食時の会話から生まれた。 1990年代初頭に開かれたある顧客向けイベントで、IBMの情報検索専門家Rakesh Agrawalは、英国の百貨店チェーンMarks & Spencerの幹部から、データベースに関する悩みを打ち明けられた。店ではあらゆる種類のデータを集めているが、そのデータをどう活用すればいいのか分からないという。 この話を聞いて、Agrawalと彼のチームは自由なキーワードを使ってクエリを実行するアルゴリズムの研究に取りかかった。そして1993年、Agrawalは後にデータマイニング分野の必読文献となる論文を発表する。この論文は現在までにおよそ650の研究論文で引用され、この分野でもっとも広く引用された論文の1つとなっている。 「本当は(論文を)送るべきかどうかすら迷っていた。ばかばかしいと思われる
ブックマークしたユーザー

すべてのユーザーの
詳細を表示します
詳細を表示します
 japan.cnet.com
 japan.cnet.com
 japan.cnet.com
 japan.cnet.com
 www.sbbit.jp
 anond.hatelabo.jp
 news.denfaminicogamer.jp
 sow.blog.jp
 qiita.com
 nomolk.hatenablog.com
 zenn.dev/nwn
 www.itmedia.co.jp
 archerhume.com
 docs.typesafe.ai
 goinger.hatenadiary.org
 www.google.com
 news.nifty.com
 b.hatena.ne.jp
 suumo.jp
 engineers.ntt.com
 levtech.jp
 www.e-aidem.com