気に入った記事をブックマーク

- 気に入った記事を保存できます
保存した記事の一覧は、はてなブックマークで確認・編集ができます
- 記事を読んだ感想やメモを書き残せます
- 非公開でブックマークすることもできます

 japan.cnet.com
エントリーの編集

エントリーの編集は全ユーザーに共通の機能です。
必ずガイドラインを一読の上ご利用ください。
 0

記事へのコメント0件
- 注目コメント
- 新着コメント
新着コメントはまだありません。
このエントリーにコメントしてみましょう。
このエントリーにコメントしてみましょう。
注目コメント算出アルゴリズムの一部にLINEヤフー株式会社の「建設的コメント順位付けモデルAPI」を使用しています
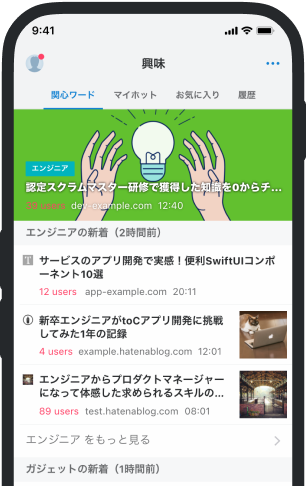
いまの話題をアプリでチェック!
- バナー広告なし
- ミュート機能あり
- ダークモード搭載
関連記事
Meta、画像内の物体を識別するAIモデル「Segment Anything Model」を公開
画像セグメンテーションとは簡単に言うと、画像内のさまざまな物体を識別することだ。例えば、箱に入っ... 画像セグメンテーションとは簡単に言うと、画像内のさまざまな物体を識別することだ。例えば、箱に入った果物の写真がある場合、画像セグメンテーションを用いたAIモデルは、Metaのデモで示されているように、個々の果物と箱を識別できるようになる。 Metaは今回、汎用の「Segment Anything Model(SAM)」と、同社として最大となるセグメンテーションデータセット「Segment Anything 1-Billion(SA-1B)」をリリースした。SA-1Bには、プライバシーに配慮したライセンス済みの1100万枚の画像と、それに対応した10億件を超えるセグメンテーションマスクが含まれている。 Metaは今回の発表に、「幅広い応用を可能にし、コンピュータービジョンの基盤モデルに向けた研究をさらに推し進めるために」(SAMとSA-1Bを)リリースしたと記している。 画像セグメンテーショ
ブックマークしたユーザー


すべてのユーザーの
詳細を表示します
詳細を表示します
 japan.cnet.com
 japan.cnet.com
 japan.cnet.com
 japan.cnet.com
 note.com/sahoobb
 landsknecht.jp
 automaton-media.com
 note.com/englishbusy
 news.yahoo.co.jp
 www.sankei.com
 anond.hatelabo.jp
 note.com/planetary_gear
 bunshun.jp
 togetter.com
 www.afpbb.com
 www.chunichi.co.jp
 av.watch.impress.co.jp
 hokka.jp
 japan.zdnet.com
 www.reifuworks.com
 www.softbank.jp
 levtech.jp
 www.hotpepper.jp
 www.hotpepper.jp